Irodori-TTSをIntel NPUで動かす - Tue, Nov 17, 2026
Writer: 西村 望久
Irodori-TTSをIntel NPU向けに移植したので、実行方法などを紹介します。
1. はじめに
最近のIntelのプロセッサには、AI処理向けのNPUが搭載されています。しかし、そのNPUを積極的に活用しているという話はあまり聞かず、せっかく載っているのに持て余している印象があります。
今回、ノートPC1台でLLMとTTS(音声合成)を同時に動かしたい場面があり、LLMはGPU、TTSはNPUという分担にすれば、うまく動かせるのではないかと考え、Irodori-TTSをIntel NPUで動かせるようにしたのでその実行方法などを紹介します。
2.1. Irodori-TTSの実行
まずはリポジトリをcloneし、NPU向けの依存関係をインストールします。
git clone https://github.com/DefiosLab/Irodori-TTS.git
cd Irodori-TTS
uv sync --extra npu
次にOpenVINOからNPUが認識されているかを確認します。出力にNPUが含まれていればOKです。もし含まれていなければIntel NPUのドライバのインストールを確認してください。
uv run --no-sync python -c "import openvino as ov; print(ov.Core().available_devices)"
あとは、通常のIrodori-TTSと同様に推論を実行することができます。
uv run --no-sync python infer.py \
  --hf-checkpoint Aratako/Irodori-TTS-v4.1-Small \
  --model-device npu \
  --codec-device npu \
  --text "こんにちは、私はAIです。これは音声合成のテストです。" \
  --no-ref \
  --output-wav outputs/sample_npu.wav
--model-device npuで音声生成モデル、--codec-device npuで音声コーデックをNPUに割り当てることができ、それぞれ個別に指定できるためどちらかのみをNPUで処理することも可能です。
初回実行時はOpenVINOへのモデルの変換やコンパイルが行われるため実行に時間がかかります。その他詳細についてはREADMEを参照してください。
2.2. Irodori-TTS-Serverの実行
Irodori-TTSには、OpenAI互換の音声生成APIを提供するIrodori-TTS-Serverがあります。こちらもパッチを適用することでNPUで動かせるため、その方法を紹介します。
まずは、Irodori-TTSとIrodori-TTS-Serverを同じディレクトリに配置し、Server側にパッチを適用します。
git clone https://github.com/Aratako/Irodori-TTS-Server.git
cd Irodori-TTS-Server

git switch --detach 61012c760f22f7b4a6c21c5c5f8f9e148120b6f9
git apply ../Irodori-TTS/docs/patches/tts-server-npu.patch
uv sync --extra npu
続いて、.env.exampleをコピーして.envを作成し以下の設定に変更します。IRODORI_PRELOAD=trueは必須ではありませんが、モデルのダウンロードやコンパイルをサーバ起動時に完了させるためtrueにしておくことを推奨します。また、fp32はCPU側の設定で、NPU内部の浮動小数点演算はfp16です。
IRODORI_HF_CHECKPOINT=Aratako/Irodori-TTS-v4.1-Small
IRODORI_MODEL_DEVICE=npu
IRODORI_CODEC_DEVICE=npu
IRODORI_MODEL_PRECISION=fp32
IRODORI_CODEC_PRECISION=fp32
IRODORI_COMPILE_MODEL=false
IRODORI_PRELOAD=true
あとはサーバを起動すれば、OpenAI互換のAPIを使用して音声合成ができます。
uv run --no-sync python -m irodori_openai_tts --host 0.0.0.0 --port 8088
curl http://localhost:8088/v1/audio/speech \
-H "Content-Type: application/json" \
-d '{
  "model": "irodori-tts",
  "input": "こんにちは。これはIrodori-TTSのAPIテストです。",
  "voice": "none",
  "response_format": "wav"
}' \
--output speech.wav
詳細なセットアップ手順や注意点は、Irodori-TTS-Server on Intel NPUを参照してください。
3. 移植と高速化の内容
今回はIntelのOpenVINOを使用し、PyTorchのモデルをOpenVINO形式に変換することでIntel NPU上で推論を実行するようにしました。
ただし、モデルをそのまま変換するだけではうまく動かなかったり、十分な性能が出ないためいくつかの調整を行いました。その変更内容を軽く紹介したいと思います。
まず、今回の実装では、入力テンソルの形状を固定してコンパイルする必要がありますが、今回使うモデルは入力テキストなどによって入力長がかわるため、入力長が変わるたびにコンパイルし直すと時間がかかってしまいます。そこで、入力長をいくつかの固定サイズ(Bucket)にわけ、それぞれのサイズでモデルをあらかじめコンパイルしておく方式を採用しました。これにより、入力長が異なっていてもコンパイル済みのモデルを使い回すことができ、毎回のコンパイルを避けて効率的に推論できるようにしました。
次に、NPUで効率よく推論するために、モデル内の演算も一部変更しています。 例えばDACVAEで使われているSnake活性化関数にはsin^2の計算が含まれています。 一般に、NPUはsinのような三角関数の計算が苦手なことがあり、LUT(Look-Up Table)や多項式近似を使って計算する方法が用いられます。 今回は、指定した範囲内での最大誤差を最小化するMinimax近似を使用し、sin^2の計算を主に乗算と加算で処理できる形に置き換えました。
また、Intel NPU向けのコンパイラには、拡張畳み込みや転置畳み込みを通常の畳み込みなどに変換する処理が実装されています。ただし、変換後の演算構成によって実行効率が変わるため、今回はこれらの演算の一部をあらかじめ通常の畳み込みを組み合わせた形に書き換え、実行効率の改善を行いました。 NPU向けの実装はopenvino_backend.pyにまとまっていますので、細かな実装についてはそちらを参照してください。
4. 実行速度
最後に、実際にIntel NPUでIrodori-TTSを動かしたときの実行速度を見ていきましょう。 今回の測定には、Intel Core Ultra 7 258Vを搭載したノートPCを使用しました。 モデルは、Irodori-TTS-v4.1-Small、サンプリングステップ数40、参照音声なし、ウォーターマークありの設定で、入力テキストの長さを17〜146文字まで変化させ、それぞれ5回のウォームアップ後に5回測定し、その結果を使用しています。
まずは、CPU、XPU(内蔵GPU)、NPUでの音声生成時間の比較です。
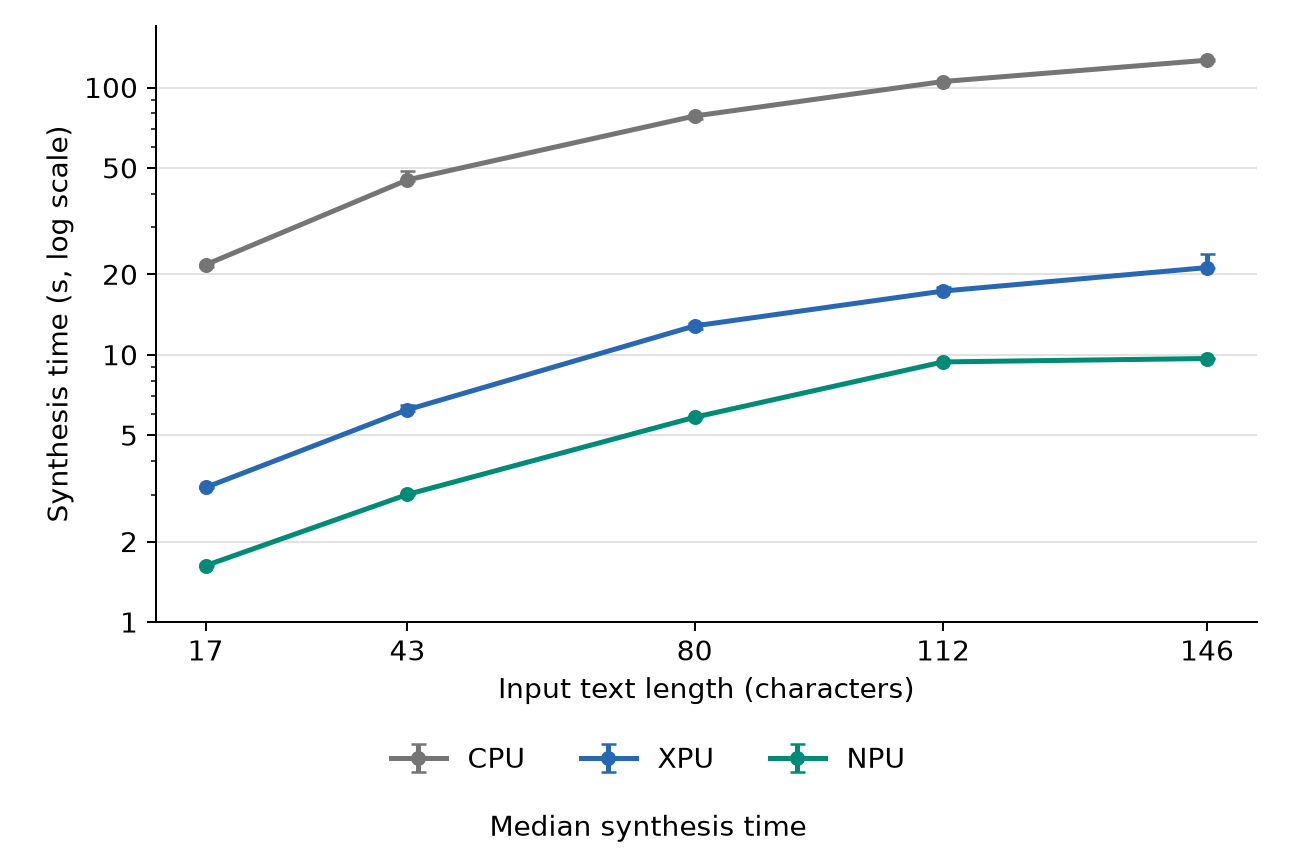
NPUでは、17文字の入力から3.68秒の音声を約1.63秒で、146文字の入力から27.2秒の音声を約9.68秒で生成できました。
続いて、生成された音声の長さに対する実行時間の比率 (RTF: Real Time Factor)を見てみます。 RTFは1.0を下まわればリアルタイムよりも高速に音声を生成できていることを意味します。
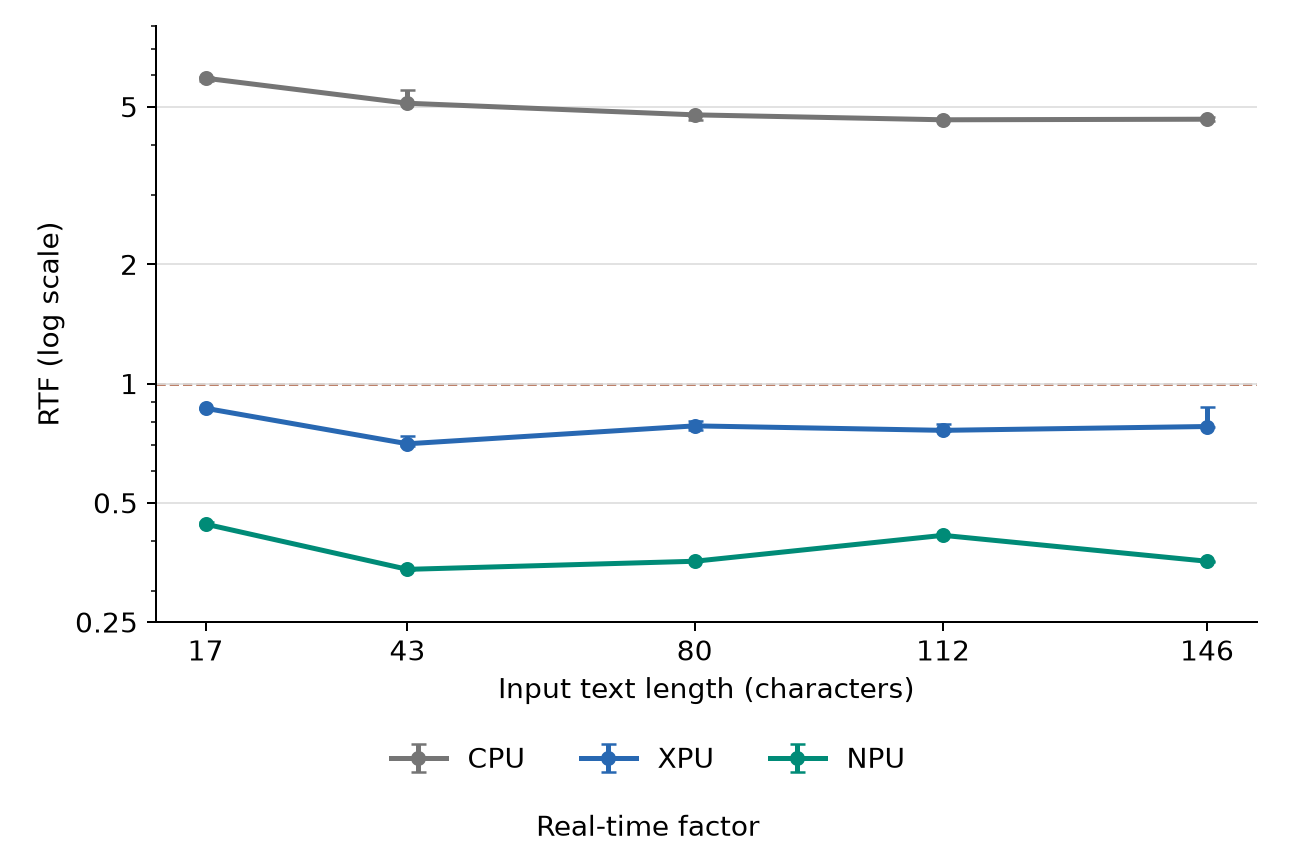
今回のケースではNPUのRTFはいずれも0.5以下となっていることがわかります。
なお、今回の測定では、NPU向けモデルの準備に約18分かかっており、この時間はコンパイル結果のキャッシュ状態によっても変わるため、上記の推論時間とは分けて考える必要があります。
5. おわりに
今回はIrodori-TTSをIntel NPUに移植し、リアルタイムを上回る速度で音声生成できることが確認できました。 この記事が、NPUを音声生成などに活用する際の参考になれば幸いです。